Sağlık sektöründe yapay zeka alanındaki yenilikçi girişim Patientdesk.ai, dil bariyerini aşma hedefiyle önemli bir adım attı. Y Combinator liderliğindeki tohum öncesi turda 1 milyon dolar yatırım alan şirket, Türkçe odaklı iki yeni ses modelini geliştirerek kullanıma sundu: Alania ve Duyu. Bu modeller, sesli asistanlar, otomatik transkripsiyon ve benzeri uygulamalar için Türkçe metin ve konuşmaları işleme yeteneği sunuyor.
Mevcut yapay zeka çözümlerinin büyük çoğunluğunun İngilizce verilerle eğitilmiş olması, Türkçe dilinin kendine özgü yapısıyla ilgili sorunlara yol açabiliyor. Alania ve Duyu modelleri, Patientdesk.ai'ın ABD'deki kliniklerdeki deneyimlerinden elde ettiği verilerle eğitildi. Özellikle Türkçe dilinin eklemeli yapısı, özel isimlerin kullanımı, telefon görüşmelerindeki düşük ses kalitesi ve konuşma sırasında aktarılan e-posta adresleri gibi faktörler, diğer modellerin performansını olumsuz etkileyebiliyor. Bu nedenle Patientdesk.ai, Türkçe diline özel olarak tasarlanmış bu modellerle, sektördeki boşluğu doldurmayı hedefliyor.
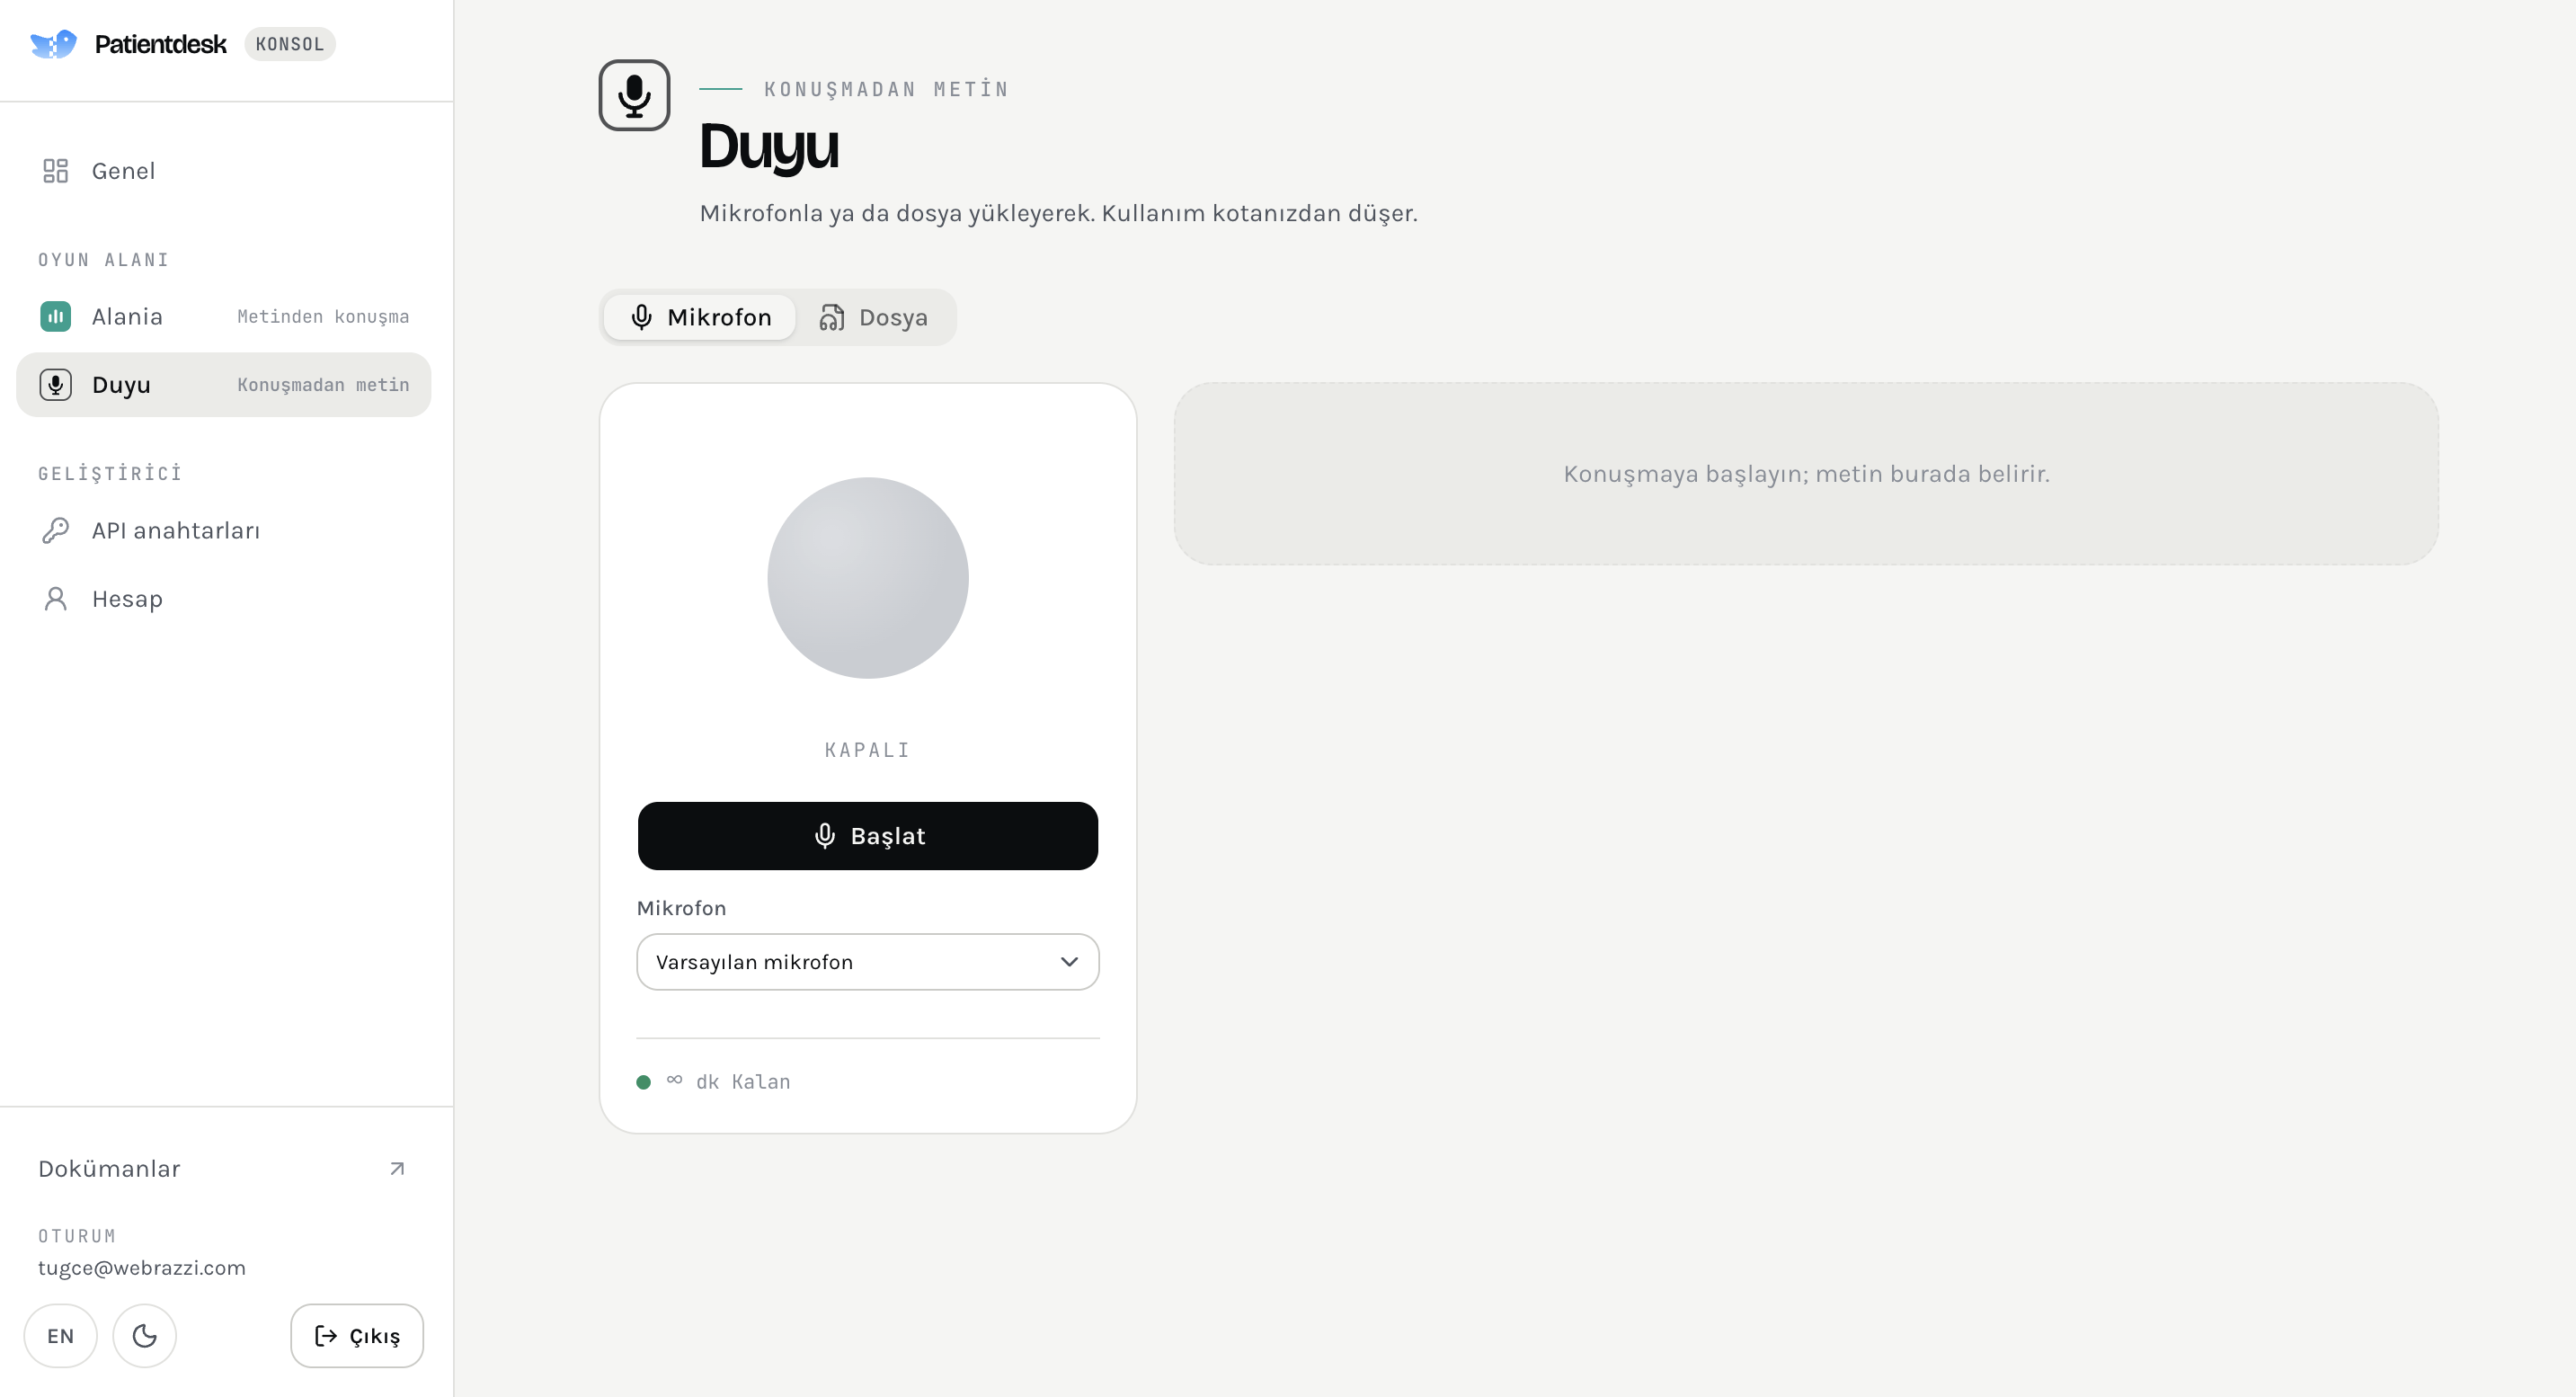
Duyu modeli, açık Türkçe okuma testi FLEURS'ta yüzde 4,71 kelime hata oranına ulaşırken, kendi test setinde bu oran yüzde 9,87'ye yükseldi. Bu sonuçlar, Duyu'nun Türkçe konuşmalarını yazıya aktarma konusunda oldukça başarılı olduğunu gösteriyor. Alania modeli ise doğal ve tutarlı bir sesle metinleri okuma odaklı tasarlandı. Cümlenin tamamlanmasını beklemeden akış halinde ses üretimi, özellikle telefon görüşmeleri ve sesli asistanlar gibi gerçek zamanlı etkileşim gerektiren uygulamalar için ideal bir çözüm sunuyor. Platformda şu an için tek bir ses seçeneği mevcut, ancak randevu, soru ve sakinleştirme gibi farklı tonlamalar da destekleniyor.
Her iki modelin de OpenAI API ile uyumlu olması, geliştiricilerin mevcut uygulamalarına kolaylıkla entegre etmelerini sağlıyor. Patientdesk.ai, kullanıcıların modelleri tarayıcı üzerinden test etmelerini ve API anahtarları oluşturmalarını da destekliyor. Ayrıca, araştırma topluluğu için Antalia-1 adlı deneysel bir model de açık kaynak olarak yayınlandı. Bu model, yaklaşık 5 saatlik Türkçe ses veri seti ve model ağırlıklarıyla birlikte sunuluyor ve ticari ürünlerden bağımsız bir araştırma projesi olarak konumlandırılıyor.